Azure Databricks data-alustan ytimessä
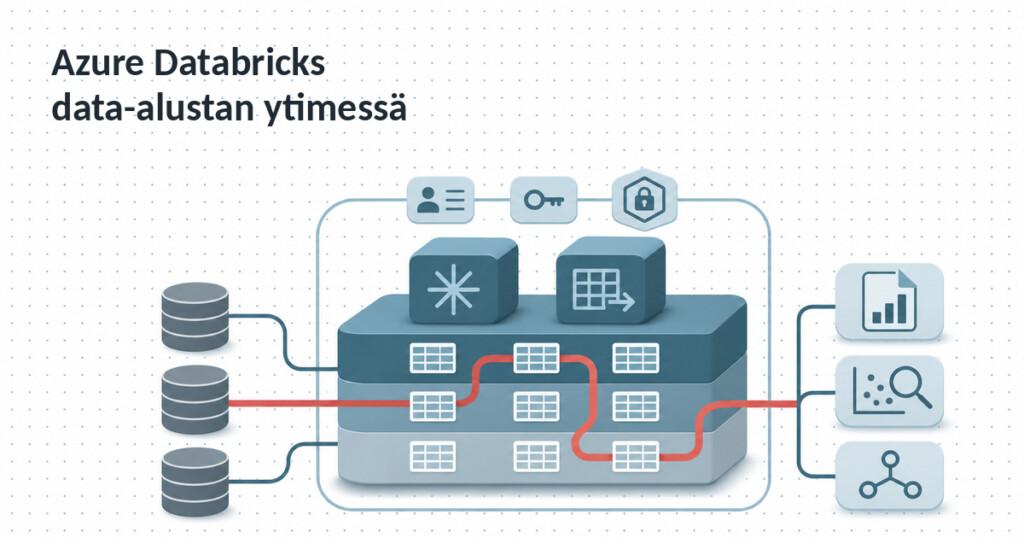
Azure Databricks ei ole vain Spark-ympäristö. Se yhdistää datan käsittelyn, SQL-analytiikan, koneoppimisen ja hallinnan samaan palveluun, jota voidaan käyttää osana organisaation data-alustaa. Tässä artikkelissa käydään läpi, mistä Azure Databricks -palvelu muodostuu ja mitä sen suunnittelussa kannattaa ottaa huomioon.
Mikä Azure Databricks on?
Azure Databricks on Microsoft Azuressa toimiva Databricks-palvelu. Se tarjoaa hallitun ympäristön suurten datamäärien käsittelyyn, analysointiin ja koneoppimiseen. Apache Spark on yksi sen keskeisistä laskentamoottoreista, mutta palvelun käyttö ei rajoitu Spark-notebookeihin: kokonaisuuteen kuuluvat myös SQL-kyselyt, ajastetut työnkulut, datan hallinta ja mallien elinkaaren työkalut.
Databricks hoitaa osan taustalla olevan laskentainfrastruktuurin hallinnasta. Organisaatio vastaa silti siitä, miten ympäristö suunnitellaan, kenelle käyttöoikeudet annetaan, miten dataa suojataan ja kuinka käyttöä seurataan. Näihin valintoihin kannattaa paneutua jo ennen ensimmäisiä tuotantoputkia.
Yksi data, useita käyttötapoja
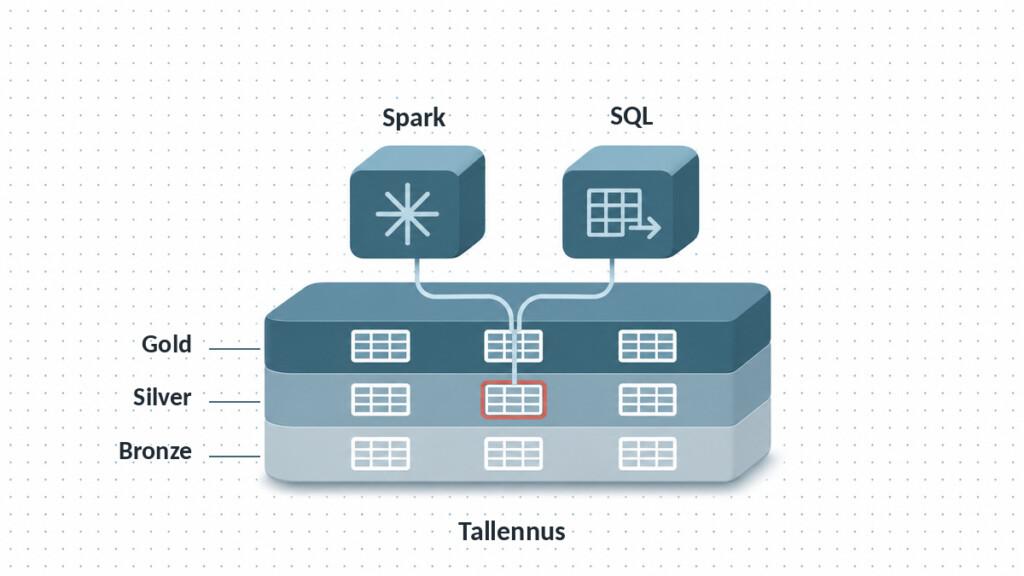
Azure Databricksin lakehouse-arkkitehtuurissa tallennus ja laskenta ovat erillisiä. Data säilyy Azure Data Lake Storage -tallennuksessa, ja sitä käsitellään tarpeen mukaan eri laskentatyypeillä.
Delta Lake tallentaa taulut Parquet-tiedostoina ja lisää niihin transaktiolokin. Sen avulla samasta taulusta voidaan ylläpitää hallittuja muutoksia, tarkistaa skeemaa ja tarkastella aiempia versioita. Dataa ei tarvitse kopioida erilliseen järjestelmään jokaista analytiikan käyttötapausta varten.
Datan käsittelyn voi jäsentää esimerkiksi medallion-malliin:
- Bronze säilyttää lähteestä tuodun datan mahdollisimman alkuperäisessä muodossa.
- Silver sisältää validoitua, siivottua ja yhdisteltyä dataa.
- Gold tarjoaa käyttötarkoitukseen mallinnetun datan raporteille, analytiikalle ja malleille.
Kerrosten nimet eivät itsessään takaa datan laatua. Jokaisessa vaiheessa tarvitaan omistajuus, laadun tarkistukset ja yhteinen käsitys siitä, mitä data tarkoittaa.
Datan lataus ja työnkulut
Azure Databricksillä voidaan rakentaa eräajoja, tiedostojen inkrementaalista latausta ja jatkuvia datavirtoja. Lakeflow-pipelineilla määritellään datan käsittelyn vaiheita, ja Lakeflow Jobsilla ajoitetaan ja orkestroidaan tehtäviä sekä niiden riippuvuuksia. Työ voi sisältää esimerkiksi notebookin, SQL-kyselyn ja putken ajon.
Työnkulkujen suunnittelussa ratkaisevaa ei ole se, kuinka monta ominaisuutta alustalla on, vaan se, mitä datan pitää tehdä ja kuinka usein. Pienelle lähdetaululle riittää usein säännöllinen lataus. Muuttuvassa tietokannassa muutosten poiminta voi olla tarkoituksenmukaisempi. Tapahtumavirtaa tarvitaan, kun käyttötapaus aidosti edellyttää jatkuvaa käsittelyä.
CI/CD ja käyttöönotot eri ympäristöihin
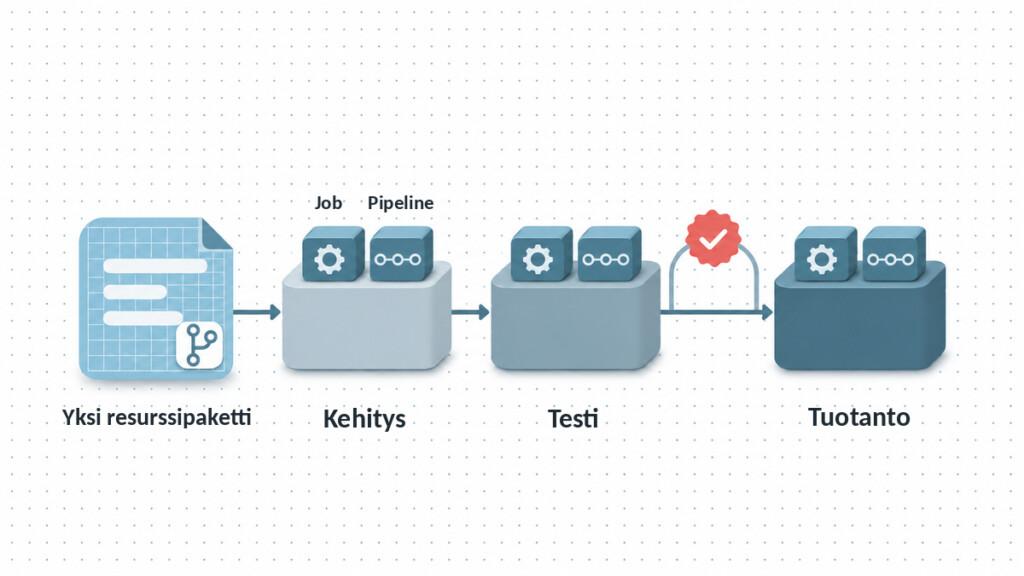
Kun datan käsittelyn työ siirtyy kehityksestä testiin ja tuotantoon, Databricksin resurssit kannattaa määritellä repositoriossa koodin rinnalla. Databricksin resurssipaketit, viralliselta nimeltään Declarative Automation Bundles, kuvaavat YAML-konfiguraatioissa esimerkiksi ajastetut työt, datan käsittelyputket ja Databricks Apps -sovellukset.
Sama paketti voidaan kohdistaa kehitys-, testi- ja tuotantoympäristöihin määrittelemällä kohteille omat asetukset. CI/CD-putki voi validoida paketin ja ottaa sen resurssit käyttöön valitussa ympäristössä. Näin muutokset kulkevat versionhallinnan ja katselmoinnin kautta, eikä jokaista ympäristöä tarvitse päivittää käsin.
Lue lisää Databricksin resurssipaketeilla hallituista siirtymistä ympäristöstä toiseen.
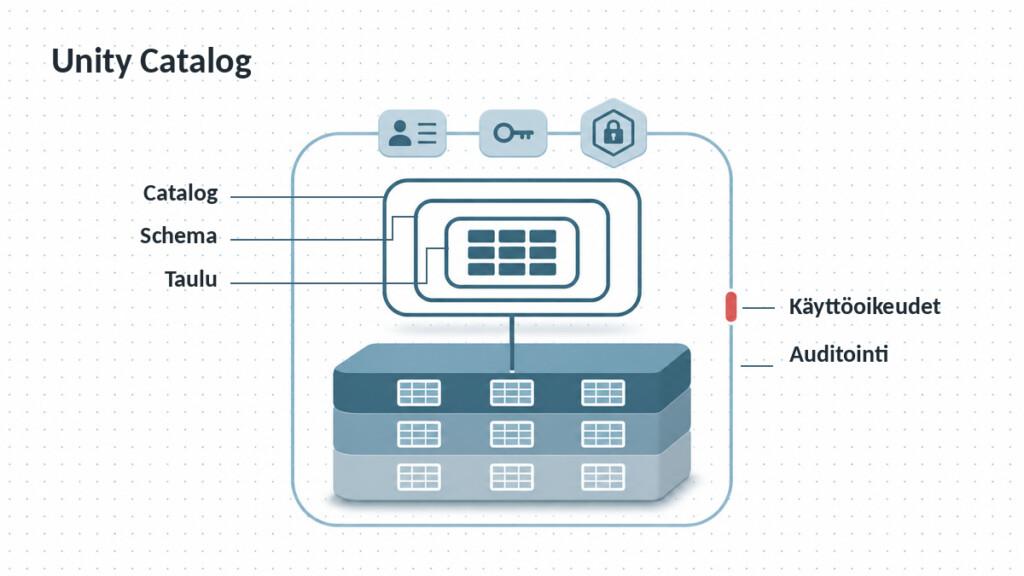
Hallinta Unity Catalogilla
Unity Catalog kokoaa Azure Databricksin datan ja muiden hallittavien resurssien käyttöoikeuksia sekä tukee auditointia, datan löydettävyyttä ja linjajäljen tarkastelua. Katalogit, skeemat ja taulut muodostavat rakenteen, jonka avulla dataa voidaan järjestää esimerkiksi liiketoiminta-alueittain.
Hallintamalli on samalla tapa sopia vastuista. Kuka omistaa tietyn data-alueen? Kuka saa käyttää sen dataa? Miten muutoksista ilmoitetaan niille, joiden työ riippuu datasta? Tekninen käyttöoikeusmalli toimii parhaiten, kun nämä kysymykset ratkaistaan yhdessä liiketoiminnan kanssa.
Koneoppiminen ja edistynyt analytiikka
Azure Databricks tukee koneoppimisen työnkulkuja datan valmistelusta kokeiden seurantaan ja mallien hallintaan. MLflowlla voidaan kirjata kokeiden parametreja ja tuloksia sekä hallita mallien elinkaarta. Malli voidaan ottaa käyttöön osana palvelua tai muuta tuotantoprosessia sen mukaan, miten ennustetta käytetään.
Mallinnus ei yksin tee ratkaisusta hyödyllistä. Ennusteen pitää liittyä päätökseen tai prosessiin, datan laadun on kestettävä käyttötarkoitus ja tulosten toimintaa on seurattava tuotannossa. Näiden kysymysten ympärille rakentuu edistynyt analytiikka.
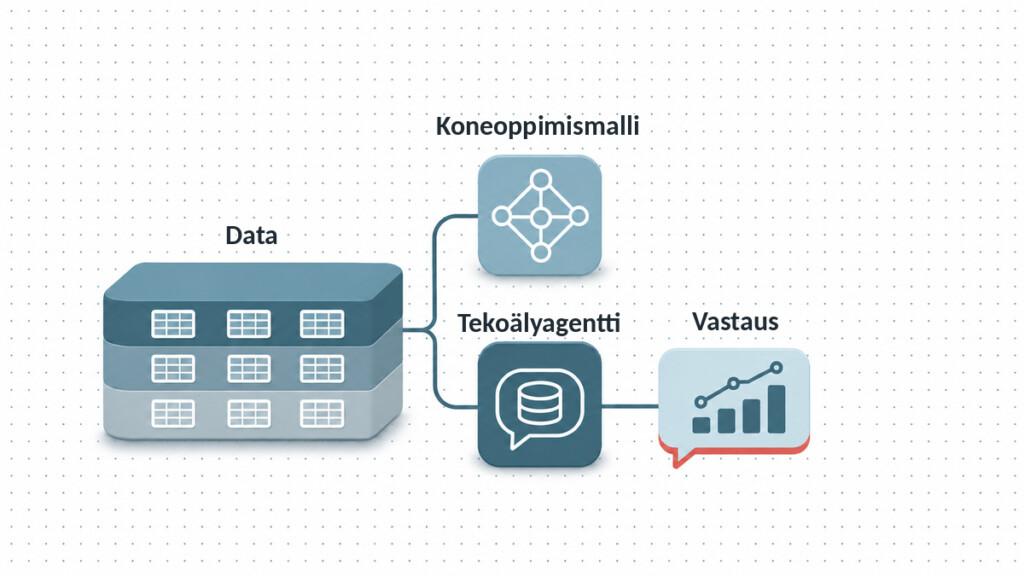
Tekoäly osana data-alustaa
Tekoälyominaisuudet voivat auttaa kehittäjiä esimerkiksi koodin kirjoittamisessa ja datan tutkimisessa. Databricksin Genie-kokemukset tuovat luonnollisen kielen käyttöliittymiä kehittäjille ja hallitun datan päälle rakennettuihin analytiikkakysymyksiin. Käyttö edellyttää silti laadukasta dataa, ymmärrettäviä liiketoimintakäsitteitä ja käyttöoikeuksia, jotka rajaavat tiedon asianmukaisesti.
Kun tavoitteena on viedä dataan perustuva tekoäly ideasta tuotantoon, mukaan tulevat myös käyttötapauksen rajaus, prosessiin kytkentä ja ratkaisun valvonta. Näitä kokonaisuuksia käsittelee tekoäly ja agentit.
Kustannukset ja tuotantokäyttö
Azure Databricksin laskentakustannukset perustuvat käytettyihin Databricks Unit -yksiköihin eli DBU-yksiköihin. Lisäksi kustannuksia syntyy muun muassa Azure-laskentainfrastruktuurista ja tallennuksesta. Lopulliseen hintaan vaikuttavat palvelutaso, valittu laskenta, käyttöaika ja kuormituksen luonne.
Kustannuksia hallitaan suunnittelemalla ympäristöt ja ajot käyttötarkoituksen mukaan. Tuotantotyöt kannattaa erottaa vuorovaikutteisesta kehityksestä, tarpeettomasti käynnissä oleva laskenta pysäyttää ja kulutusta seurata työkuormittain. Mitoitus kannattaa varmistaa todellisilla ajoilla eikä pelkillä oletuksilla.
Milloin Azure Databricks sopii?
Azure Databricks on harkinnan arvoinen, kun organisaatio tarvitsee skaalautuvaa datan käsittelyä, Spark-pohjaista kehitystä, SQL-analytiikkaa tai koneoppimisen työnkulkuja. Se voi sopia myös osaksi laajempaa Microsoft Azure -kokonaisuutta. Valinta tehdään kuitenkin vaatimusten, osaamisen ja käyttötapojen perusteella; yksi alusta ei automaattisesti ole paras kaikkiin tarpeisiin.
Databricksin tekninen käyttöönotto on vain osa työtä. Kokonaisuudessa pitää huomioida lähdejärjestelmät, tietoturva, kustannukset, datan omistajuus ja se, miten alusta palvelee käyttäjiä. Tätä kokonaisuutta rakennetaan data-alustan kehittämisessä.
Yhteenveto
- Azure Databricks yhdistää data engineeringin, SQL-analytiikan ja koneoppimisen saman palvelun alle.
- Delta Lake mahdollistaa dataa hyödyntävät työkuormat avoimessa tiedostopohjaisessa tallennuskerroksessa.
- Lakeflow auttaa määrittelemään datan käsittelyn ja orkestroimaan sen työnkulkuja.
- Unity Catalog tukee datan hallintaa, käyttöoikeuksia ja löydettävyyttä.
- Onnistunut alusta tarvitsee teknologian lisäksi selkeän hallintamallin, kustannusseurannan ja yhteyden liiketoiminnan tarpeisiin.
Azure Databricks osaksi data-alustaa
Suunnitteletko uuden alustan rakentamista tai nykyisen ympäristön uudistamista? Arvioi ensin nykyinen ympäristö, tärkeimmät käyttötapaukset ja se, miten Databricks sopii organisaatiosi tavoitteisiin sekä muuhun Azure-ympäristöön.
Lisää ajankohtaisia julkaisuja:
Mikä on Power BI?
Mitä on tietomallintaminen?
Julkaistu 11.10.2026. Kirjoitus korvaa kaksi aiempaa kirjoitustamme: Esittelyssä kolme yleistä tietomallinnusmenetelmää ja Dimensiot ja hierarkiat tietomallissa.
Mikä on moderni data-alusta?
Päivitetty 10.10.2026. Kirjoitus kokoaa yhteen ja päivittää kolme aiempaa Data Platform -kirjoitustamme.
Mikä on semanttinen kerros?
Mitä on Unit Economics -analyysi?
Lisää ajankohtaisia julkaisuja:
Mikä on Power BI?
Mitä on tietomallintaminen?
Julkaistu 11.10.2026. Kirjoitus korvaa kaksi aiempaa kirjoitustamme: Esittelyssä kolme yleistä tietomallinnusmenetelmää ja Dimensiot ja hierarkiat tietomallissa.
Mikä on moderni data-alusta?
Päivitetty 10.10.2026. Kirjoitus kokoaa yhteen ja päivittää kolme aiempaa Data Platform -kirjoitustamme.