Mikä on moderni data-alusta?
Päivitetty 10.10.2026. Kirjoitus kokoaa yhteen ja päivittää kolme aiempaa Data Platform -kirjoitustamme.
Moderni data-alusta lyhyesti
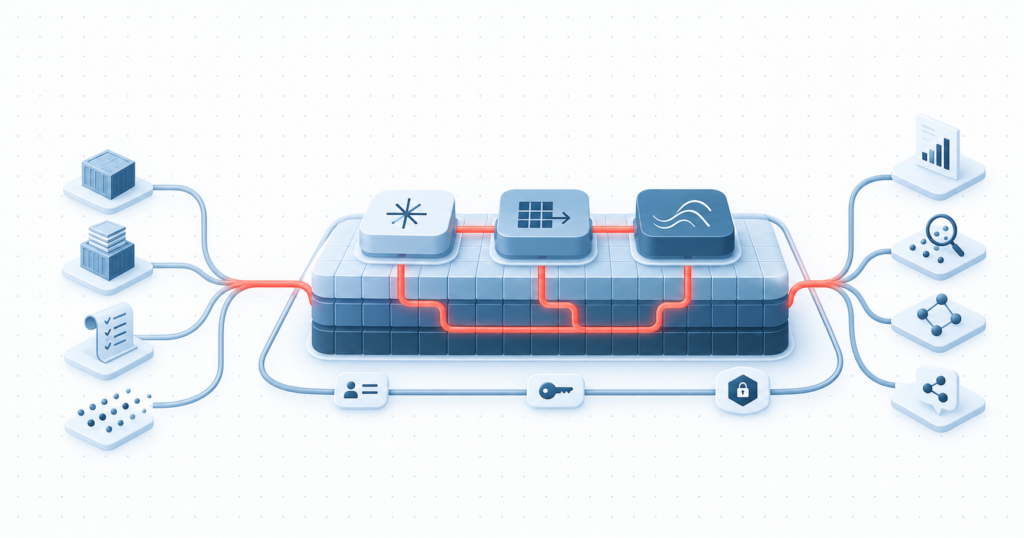
Moderni data-alusta on yleensä joukko pilvipalveluita, jotka yhdessä:
- tallentavat datan avoimessa tiedostomuodossa, kuten Delta Lake -tauluina, yhteen tallennuskerrokseen
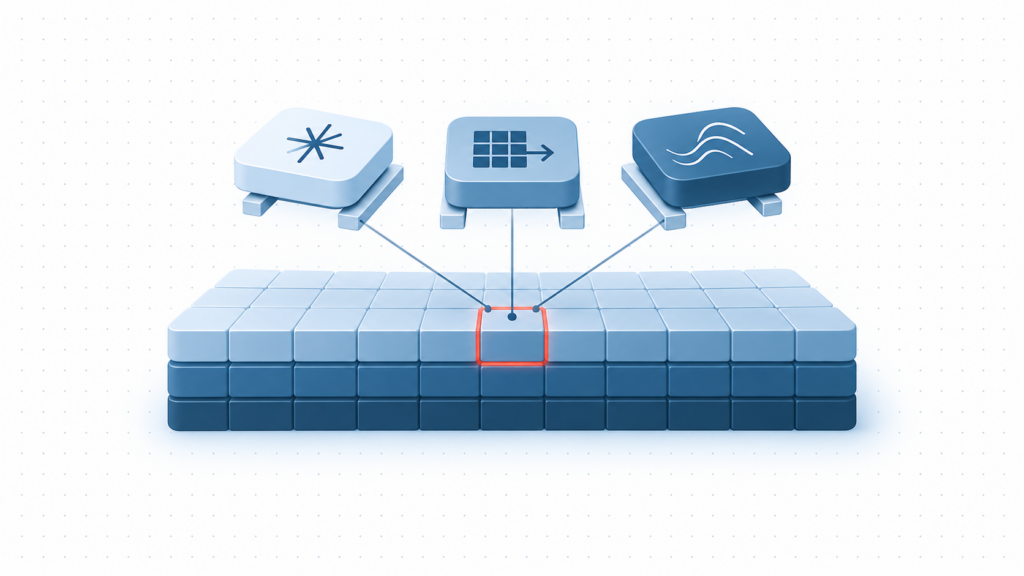
- käsittelevät datan alustan sisällä usealla laskentamoottorilla (Spark, SQL, KQL), eikä dataa tarvitse siirtää muualle muokattavaksi
- ottavat dataa vastaan eräajoina, replikointina ja tapahtumavirtoina
- hallitsevat käyttöoikeudet, salaisuudet ja verkkoliikenteen keskitetysti
- jakavat saman datan raporteille, analytiikalle, koneoppimismalleille ja data-agenteille
Azuressa alustan ytimen muodostaa tyypillisesti Microsoft Fabric tai Azure Databricks. Niiden ympärille tulevat identiteetin, tietoturvan, verkon ja integraatioiden palvelut.
Data elää pidempään kuin sovellukset
Organisaation toiminnan keskiössä ovat liiketoimintaprosessit ja niiden käsittelemät asiat, kuten asiakkaat, sopimukset, tilaukset ja laskut. Siksi prosessi- ja käsitemallinnus ovat hyviä tapoja kuvata liiketoimintaa. Tiedonhallinta kulkee mukana jokaisessa prosessissa, ja sen tehtävä on varmistaa, että liiketoimintaa voidaan johtaa ja kehittää datan avulla.
Liiketoimintaa ajatellaan usein liikaa sovellusten kautta, ikään kuin kulloinkin käytössä olevat järjestelmät olisivat itse prosessi. ERP ja CRM vaihtuvat, mutta asiakas, sopimus ja lasku säilyvät. Prosessit ja data ovat yksittäisiä sovelluksia pysyvämpiä. Tämä datakeskeinen ajattelumalli on hyvän data-alustan lähtökohta. Kun alusta rakennetaan liiketoiminnan käsitteiden ympärille, se kestää lähdejärjestelmien vaihdokset.
Mikä tekee data-alustasta modernin?
Tallennus ja laskenta on erotettu toisistaan
Moderni data-alusta käsittelee monenlaista dataa: relaatiotauluja, tiedostoja, tapahtumavirtoja ja puolirakenteista dataa. Nykyään se rakennetaan tyypillisesti lakehouse-arkkitehtuurilla. Data tallennetaan edulliseen object storage -tallennukseen avoimessa Delta Lake -muodossa, ja samaa dataa käsitellään eri moottoreilla tarpeen mukaan. Erillistä analyyttistä tietokantatuotetta ei välttämättä tarvita lainkaan.
Data käsitellään alustan sisällä. Sitä ei siirretä ulkopuoliselle integraatiopalvelimelle muokattavaksi ja ladata takaisin. Medallion-arkkitehtuuri jäsentää käsittelyn kerroksiin: raakadata (bronze), puhdistettu ja yhdistetty data (silver) ja käyttövalmis data (gold).
Pilvipalvelu siirtää infran ylläpidon palveluntarjoajalle
Data-alusta voi edelleen olla on-premises, mutta useimmiten se on kokoelma pilvipalveluita. Kun alusta koostuu Serverless-, PaaS- ja SaaS-palveluista, palveluntarjoaja vastaa suuresta osasta sitä teknistä infrastruktuuria, jonka organisaatio on-premises-mallissa hoitaa itse. Resursseja voi skaalata ylös ja alas tarpeen mukaan.
Pilven suurin hyöty on joustavuus. Kehittämisestä ja käytetyistä infrapalveluista joutuu maksamaan joka tapauksessa. Pilvi muuttaa pääomainvestoinnit käyttömenoiksi, mikä vaatii uudenlaista kustannusten seurantaa.
Infraa suurempi kuluerä on yleensä kehitystyö, joko oman tiimin palkkoina tai ostettuna palveluna. Siksi kannattaa automatisoida ja käyttää lähes valmiita komponentteja aina kun mahdollista. Nykyään tähän kuuluu myös tekoälyavusteinen data engineering. Siinä kielimalli tuottaa rutiininomaisen putkikoodin, ja kehittäjä tarkistaa sen ja keskittyy tietomalliin, arkkitehtuuriin ja liiketoimintasääntöihin.
Integraatiotyylit ovat muuttuneet
Datamäärät kasvavat ja eräajoikkunat lyhenevät. Kaiken datan kierrättäminen yhden integraatiopalvelimen kautta ei enää toimi näissä olosuhteissa. Reaaliaikaisuus, sanomapohjainen integraatio ja replikointi ovat yleistyneet koko 2020-luvun, ja pilvialustoissa ne ovat nykyään valmiita ominaisuuksia.
Miten data saadaan alustalle?
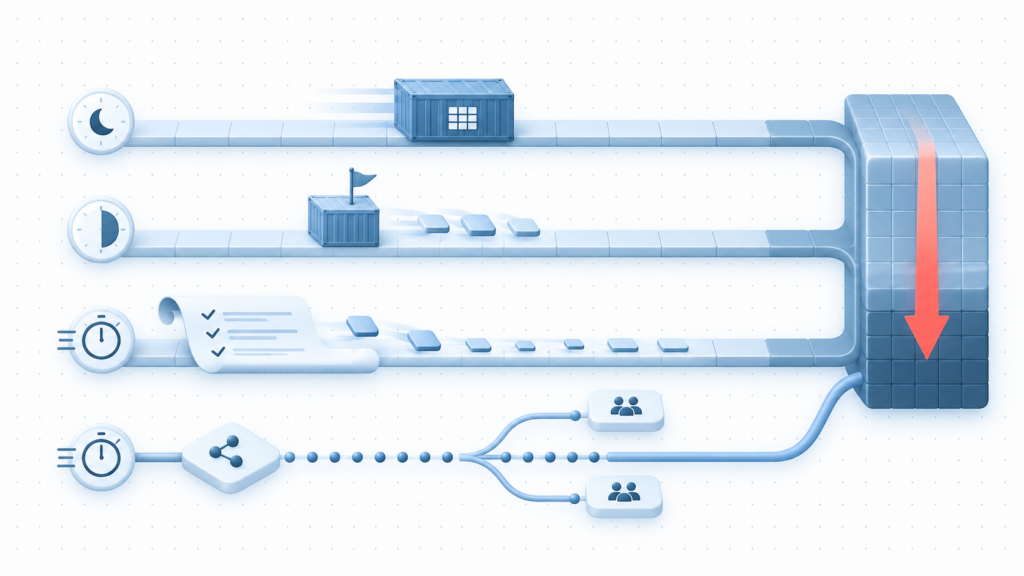
Dataa voi siirtää lähteestä alustalle usealla tavalla. Valinta riippuu datamäärästä, muutostahdista ja siitä, kuinka tuoretta datan pitää olla.
| Tapa | Milloin sopii | Esimerkki Azuressa |
|---|---|---|
| Täyslataus (copy and upsert) | Pienet lähdetaulut, jotka on nopea ladata kokonaan | Fabricin Data Factory -putki tai Azure Data Factory |
| Inkrementaalinen lataus | Lähteessä on luotettava muutosindikaattori, kuten muokkausaikaleima | Data Factory -putki, Azure Databricksin Auto Loader tiedostoille |
| Lokipohjainen replikointi (CDC) | Suuret, usein muuttuvat tietokannat | Microsoft Fabricin Mirroring, Debezium |
| Tapahtumavirrat (julkaisija–tilaaja) | Lähes reaaliaikainen tarve, sanomapohjaiset järjestelmät | Azure Event Hubs (Kafka-yhteensopiva), Fabricin Eventstream |
Replikointi
Replikointi on datan kopiointia lähteestä kohteeseen. Lokipohjainen replikointi (change data capture, CDC) lukee muutokset tietokannan transaktiolokista. Siitä on kolme hyötyä:
- Siirrettävä datamäärä on pienempi kuin perinteisessä eräajossa
- Data päivittyy lähes reaaliajassa
- Lähdetietokannan kuormitus jää kevyeksi
Replikoinnissa on myös kustannuksia ja riskejä:
- Käyttöönotto voi vaatia toimenpiteitä tietokantojen ylläpitäjiltä tai ICT:ltä
- Jos synkronointi katkeaa, se pitää käynnistää uudelleen ja selvittää, mitä jäi siirtymättä
- Yksi tuote ei välttämättä kata kaikkia lähdejärjestelmiä
- Tiedostopohjaisissa integraatioissa eräajo on usein yksinkertaisempi ratkaisu
On-premises-ympäristössä replikointituotteet ovat perinteisesti olleet kalliita, eivätkä tietokantojen omat replikointitoiminnot ole tukeneet siirtoa erilaisten järjestelmien välillä. Pilvessä tilanne on toinen. Microsoft Fabricin Mirroring replikoi esimerkiksi Azure SQL Databasen, SQL Serverin, Oraclen ja Snowflaken tauluja lähes reaaliajassa OneLakeen Delta-muotoon. Replikoinnin taustalaskenta ei kuluta Fabric-kapasiteettia, ja jokainen ostettu kapasiteettiyksikkö (CU) sisältää teratavun maksutonta tallennustilaa peilatulle datalle.
Keskitetty monoliitti vai hajautettu Data Mesh?
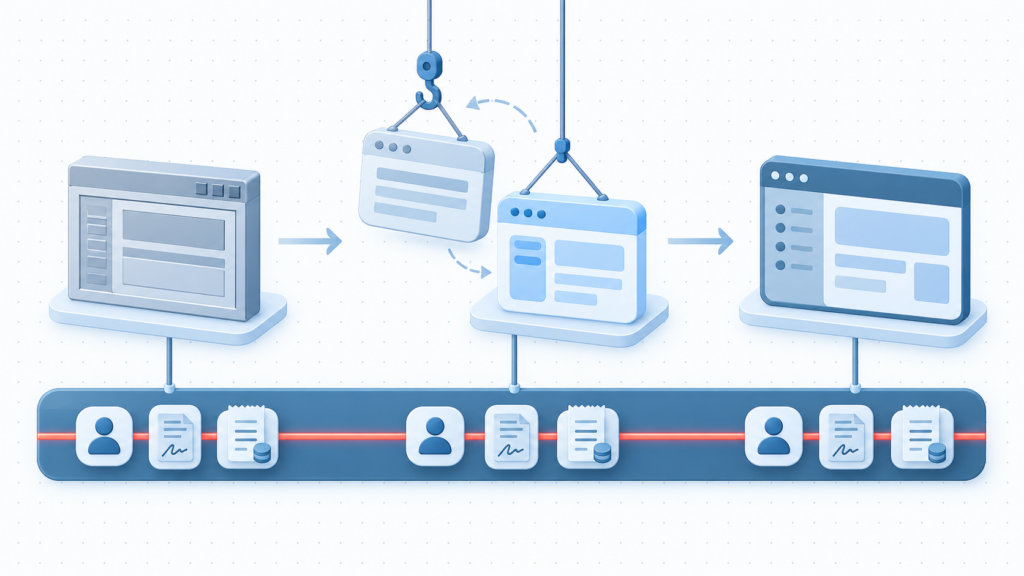
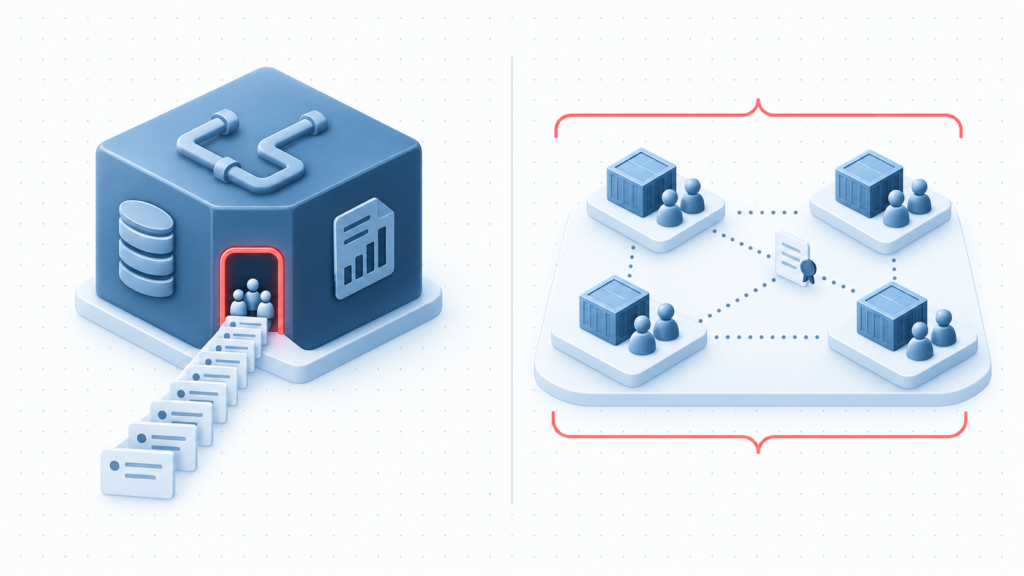
Monoliittisessa data-alustassa komponentit riippuvat toisistaan niin paljon, ettei yhtä osaa voi muuttaa ja viedä julkaisuputkessa eteenpäin huomioimatta muita. Yksittäistä komponenttia ei voi julkaista itsenäisesti muihin ympäristöihin. Monoliittiin liittyy usein keskitetty tietovarastotiimi, joka vastaa kaikesta kehityksestä ja palvelulupauksesta datan käyttäjille. Keskittäminen on ollut luonteva ratkaisu, koska liiketoimintaprosesseilla on harvoin ollut kykyä tuottaa dataa palveluna. Sen haittapuoli on hitaus, kun yksi tiimi on pullonkaula kaikille muutoksille.
Data Mesh hajauttaa vastuun ja arkkitehtuurin liiketoiminnan ilmiöalueille eli domaineille. Jokainen domain tuottaa omat datatuotteensa ja vastaa niiden palvelulupauksesta datan käyttäjille. Malli edellyttää vahvaa resursointia, koska jokaisen domainin pitää ymmärtää oman datatuotteensa luonne. Käyttöönotto muuttaa ajattelutapaa paljon, eikä se tapahdu nopeasti.
Teknologia tukee molempia malleja. Microsoft Fabricissa domainit ryhmittelevät työtiloja liiketoiminta-alueittain, ja OneLake-pikakuvakkeet jakavat dataa domainien välillä ilman kopiointia. Azure Databricksissä Unity Catalogin katalogit toimivat domainien rajoina.
Datasopimus sitoo tuottajan ja käyttäjän
Datasopimus (data contract) on muodollinen sopimus datan tuottajan ja käyttäjän välillä, joko saman organisaation sisällä tai ulkoisten osapuolten kesken. Se kuvaa datatuotteen palvelulupauksen palvelutasosopimuksen tapaan ja määrittää roolit, vastuut ja oikeudet. Sopimus kattaa tyypillisesti skeeman, kenttien liiketoimintamerkityksen, laatuodotukset, päivitysaikataulun ja omistajan. Se voi sisältää myös osia, joilla esimerkiksi sanomat validoidaan automaattisesti.
Datasopimus liittää datan domainiin, jolloin data ei ole sidottu yhteen lähdejärjestelmään. Datatuotteet, datasopimukset ja Data Mesh kytkeytyvät siksi tiiviisti toisiinsa. Käytännön toteutusta Fabricissa ja Databricksissä käsitellään kirjoituksessa Datasopimus käytännössä.
Azuren rakennuspalikat modernille data-alustalle
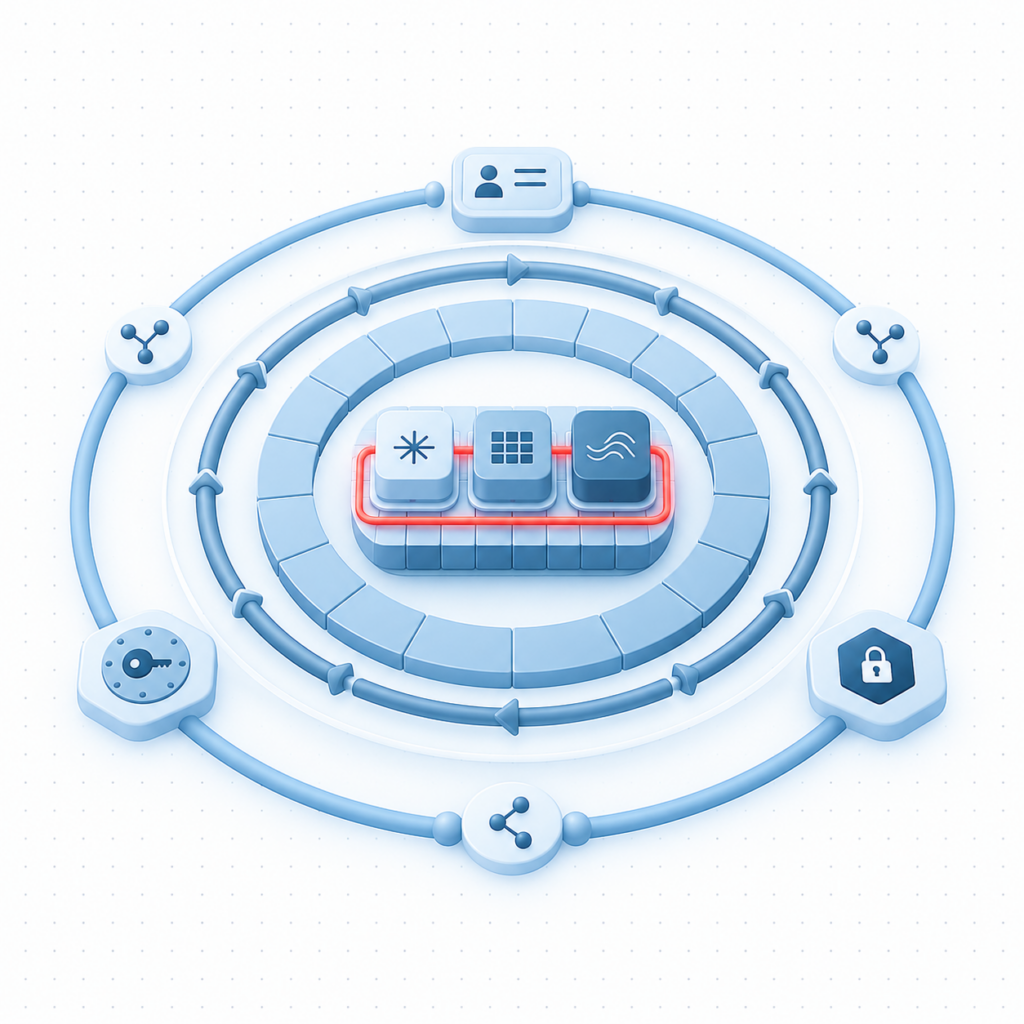
Pilvessä yksi palvelu kattaa harvoin kaikki tarpeet. Data-alusta kootaan useasta palvelusta, joista jokainen hoitaa oman tehtävänsä.
| Kerros | Azure-palvelut | Tehtävä |
|---|---|---|
| Identiteetti ja oikeudet | Microsoft Entra ID, Azure RBAC | Kuka pääsee mihinkin |
| Salaisuudet ja avaimet | Azure Key Vault, Managed HSM | Tunnukset ja salausavaimet pois koodista |
| Verkko | Azure Virtual Network, private endpointit | Liikenteen eristäminen julkisesta internetistä |
| Tallennus | Azure Data Lake Storage, OneLake | Datan pysyväistallennus avoimessa muodossa |
| Analytiikka | Microsoft Fabric, Azure Databricks | Datan käsittely, mallinnus ja jakelu |
| Integraatio | Data Factory, Azure Logic Apps, Azure Functions | Datan siirto, orkestrointi ja tapahtumat |
| Kehitys ja julkaisu | Azure DevOps, GitHub | Versionhallinta ja CI/CD |
Identiteetti ja käyttöoikeudet: Microsoft Entra ID
Keskitetty identiteettien ja roolipohjaisten käyttöoikeuksien (RBAC) hallinta on toimivan data-alustan perusta. Azuressa oikeudet kannattaa myöntää hallintaryhmä- eli management group -tasolla, josta ne periytyvät tilauksille ja resurssiryhmille. Roolit annetaan Entra ID -ryhmille, ja käyttäjät lisätään ryhmiin. Ohjelmallisille tunnuksille kannattaa käyttää hallittuja identiteettejä (managed identity), jolloin salasanoja ei tarvitse säilyttää lainkaan.
Ryhmät pitävät myös roolimääritysten määrän hallinnassa. Yhdessä Azure-tilauksessa voi olla enintään 5 000 roolimääritystä ja hallintaryhmässä 500, eikä rajoja voi nostaa. Oikeusrakenne kannattaa suunnitella osana Azuren hallintamallia ennen kuin data-alustaa aletaan rakentaa.
Salaisuudet ja avaimet: Azure Key Vault
Azure Key Vault tallentaa salaisuudet, avaimet ja sertifikaatit. Kun data-alusta käyttää Key Vaultia, koodiin ja konfiguraatiotiedostoihin ei tallenneta arkaluontoista tietoa. Key Vaultiin tunnistaudutaan Entra ID:llä, ja oikeudet myönnetään Azure RBAC -mallilla. Microsoft suosittelee RBAC-mallia vanhojen pääsykäytäntöjen (access policies) sijaan, ja API-versiosta 2026-02-01 alkaen se on uusien key vaultien oletus.
Tiukimpiin vaatimuksiin on Azure Key Vault Managed HSM. Se on yhdelle asiakkaalle dedikoitu, FIPS 140-3 Level 3 -validoitu laitteistoturvamoduulipalvelu, johon voi tuoda omassa on-premises-HSM:ssä luotuja avaimia (BYOK).
Verkko: Azure Virtual Network ja private endpointit
Azure Virtual Network (VNet) mahdollistaa turvallisen liikenteen resurssien välillä Azuressa ja hybridimallissa myös on-premises-ympäristöön. Aliverkoilla (subnet) verkkoa segmentoidaan. Esimerkiksi tietokantaan pääsee vain sovelluspalvelimen aliverkosta, eikä suoraa yhteyttä julkiseen internetiin ole.
Service endpointit ja private endpointit tuovat Azuren resurssitasoiset palomuurisäännöt osaksi segmentointia. Private endpointilla resurssi tuodaan suoraan aliverkon sisälle ja sen julkinen saavutettavuus estetään. Aliverkon voi myös dedikoida yksittäiselle palvelulle, kuten Azure Databricksille (VNet injection). Microsoft Fabricissa samaan päästään hallituilla private endpointeilla ja VNet data gatewaylla.
Tallennus: Azure Data Lake Storage ja OneLake
Azure Storage sisältää Blob-, File-, Table- ja Queue-palvelut. Kun tallennustilille otetaan käyttöön hierarkkinen nimiavaruus (hierarchical namespace), sitä voi käyttää Azure Data Lake Storagena, joka on esimerkiksi Azure Databricksin lakehousen tallennuskerros. Object storage on tietokantatuotteisiin verrattuna edullinen paikka suurille datamäärille.
Microsoft Fabricissa tallennuskerros on OneLake, joka on rakennettu Azure Data Lake Storagen päälle. Jokaisella Fabric-tenantilla on yksi OneLake, eikä sitä tarvitse provisioida erikseen.
Analytiikka: Microsoft Fabric ja Azure Databricks
Lakehouse-analytiikan kaksi päävaihtoehtoa Azuressa ovat Microsoft Fabric ja Azure Databricks.
- Microsoft Fabric on SaaS-palvelu, joka kokoaa Data Factoryn, Spark-pohjaisen data engineeringin, tietovaraston, reaaliaikaisen analytiikan ja Power BI:n samaan ympäristöön. Kustannus perustuu ostettuun kapasiteettiin.
- Azure Databricks on PaaS-palvelu, jossa Spark, Databricks SQL, Lakeflow Jobs -orkestrointi ja MLflow toimivat Unity Catalogin hallinnoimina. Kustannus perustuu käytettyyn laskentaan (DBU).
Molemmilla rakennetaan medallion-arkkitehtuurin mukainen lakehouse, ja ne toimivat myös yhdessä. Fabric lukee Databricksin Delta-tauluja OneLake-pikakuvakkeilla ja Unity Catalogin peilauksella ilman kopiointia.
Azure SQL Database sopii edelleen operatiivisten sovellusten tietokannaksi ja pieniin raportointikantoihin, mutta tietovarastokäytössä se vaatii erillistä indeksointi- ja partitiointisuunnittelua. Uudet analytiikkatoteutukset kannattaa tehdä Fabriciin tai Databricksiin Azure Synapse Analyticsin sijaan. Synapsen dedicated SQL pooleista Fabric Data Warehouseen siirtymiseen Microsoft tarjoaa oman työkalun, Fabric Migration Assistantin.
Integraatio ja orkestrointi: Data Factory, Logic Apps ja Azure Functions
- Data Factory lataa dataa lähdejärjestelmistä data-alustalle ja takaisin sekä ajastaa, orkestroi ja valvoo ajoketjuja. Se käynnistää myös muiden palveluiden töitä, kuten Azure Databricksin notebookeja. Microsoft kuvaa Fabricin Data Factorya Azure Data Factoryn seuraavaksi sukupolveksi, joten uudet toteutukset kannattaa aloittaa siitä. Molemmat kannattaa kytkeä Git-versionhallintaan.
- Azure Logic Apps on low-code-palvelu työnkulkujen ja prosessien automatisointiin. Se sopii tilanteisiin, joissa reagoidaan ulkoiseen tapahtumaan, mutta suurten datamäärien siirtoon se ei ole tarkoitettu. Integration Account tuo B2B-integraatioihin sanomamuunnokset ja sanomien validoinnin.
- Azure Functions on serverless-palvelu tapahtumiin reagoivalle koodille. Microsoft huolehtii ajoympäristöstä, ja kehittäjä kirjoittaa logiikan esimerkiksi Pythonilla tai C#:lla. Funktion voi käynnistää myös Data Factory -putkesta.
Versionhallinta ja julkaisu: Azure DevOps tai GitHub
Data-alustan koodi, putkimäärittelyt ja infrastruktuuri kuuluvat Git-versionhallintaan. Azure DevOps tarjoaa versionhallinnan (Azure Repos) ja CI/CD-putket (Azure Pipelines), GitHub vastaavasti repositoryt ja GitHub Actionsin. Build-vaihe kokoaa julkaistavan paketin kerran, ja release-vaihe vie saman paketin kehitys-, testi- ja tuotantoympäristöihin. Microsoft Fabricin työtilat voi kytkeä suoraan Azure DevOpsin tai GitHubin repositoryyn, ja Azure Databricksissä julkaisut määritellään Declarative Automation Bundles -tiedostoilla.
Monoliitin ongelma näkyy juuri julkaisuissa. Jos komponentteja ei voi julkaista erikseen, jokainen muutos odottaa kaikkia muita.
Mistä liikkeelle?
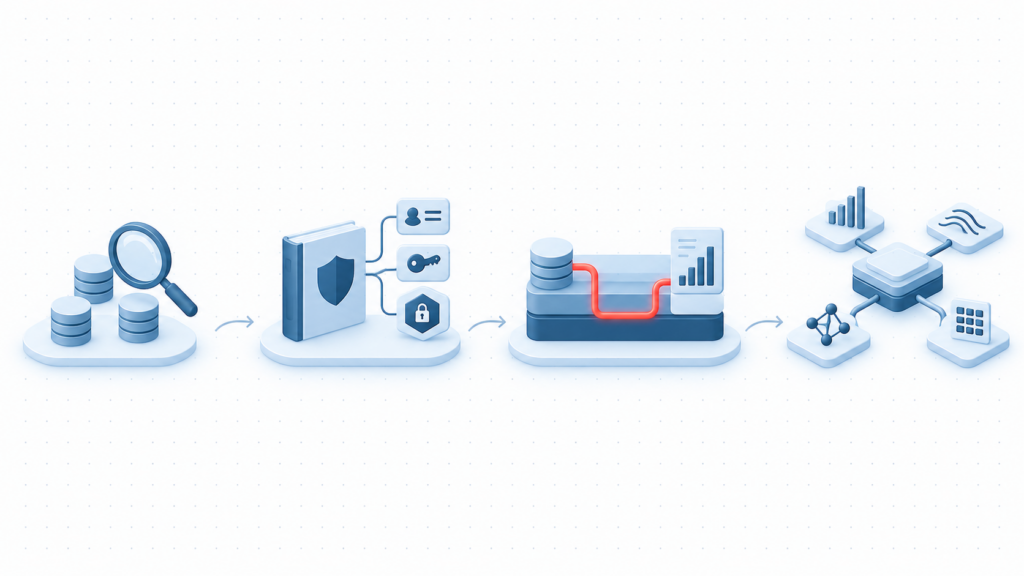
Moderni data-alusta rakennetaan vaiheittain:
1. Kartoita nykytila. Selvitä lähdejärjestelmät, datan käyttäjät ja suurimmat kipupisteet.
2. Sovi hallintamalli. Laita identiteetit, verkko, salaisuudet ja kustannusten seuranta kuntoon ennen ensimmäistä dataputkea.
3. Rakenna yksi putki läpi. Vie yhden lähdejärjestelmän data kaikkien medallion-kerrosten kautta raporttiin asti. Se osoittaa, että arkkitehtuuri toimii käytännössä.
4. Laajenna domain kerrallaan. Vie jokainen uusi data-alue tuotantoon ennen seuraavaa.
Vaiheet ja niiden riskit on kuvattu tarkemmin kirjoituksessa Millainen on data-alustan kehittämisprojekti?
Suunnitteletko data-alustan uudistamista?
Kerro meille, millainen data-alusta teillä on nyt ja mitä sen pitäisi pystyä tekemään. Käydään 30 minuutissa läpi nykytila, suurimmat kipupisteet ja realistinen etenemistapa Microsoft Fabricilla, Azure Databricksillä tai niiden yhdistelmällä.
Varaa maksuton kartoituskeskustelu →
Lue lisää palvelustamme: Data-alustan kehittäminen